Daten teilen, vertrauenswürdige KI ermöglichen
Am Swiss Data Space Forum vom 28. Oktober 2026 stand die Frage im Zentrum, wie gemeinsam genutzte Daten die Entwicklung vertrauenswürdiger künstlicher Intelligenz unterstützen können. Die Beiträge zeigten: Neben technischen Lösungen braucht es klare Verantwortlichkeiten, wirtschaftliche Anreize und eine langfristige Finanzierung.
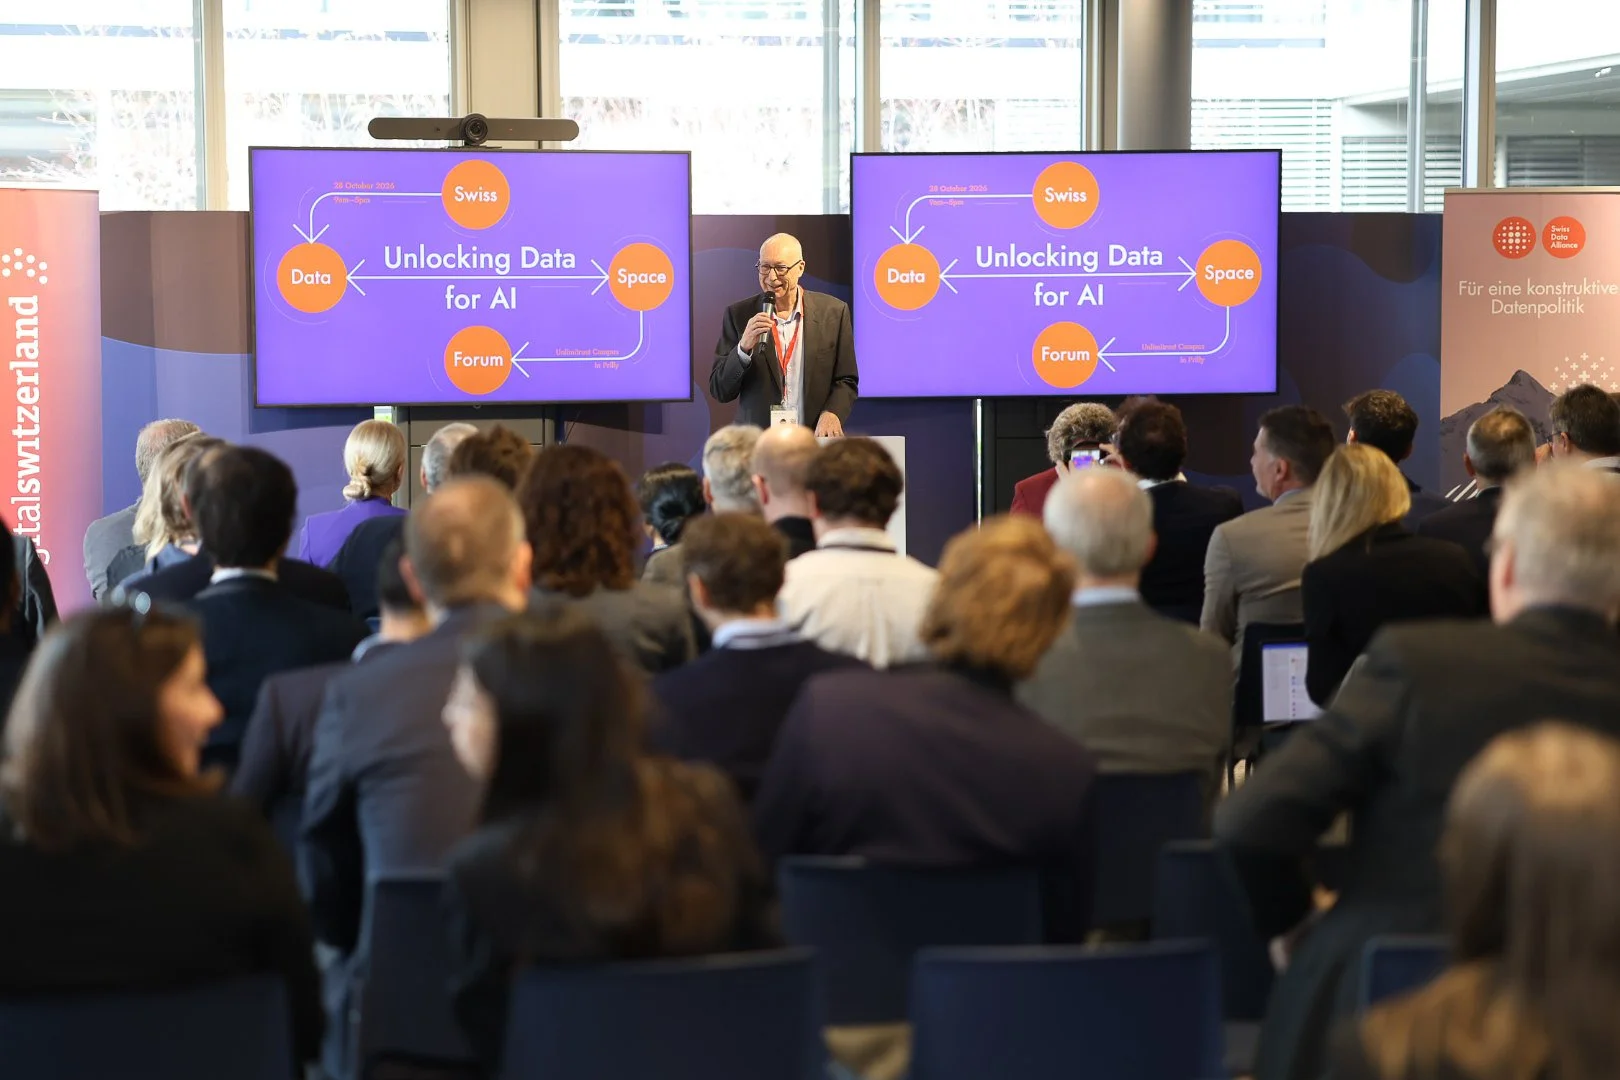
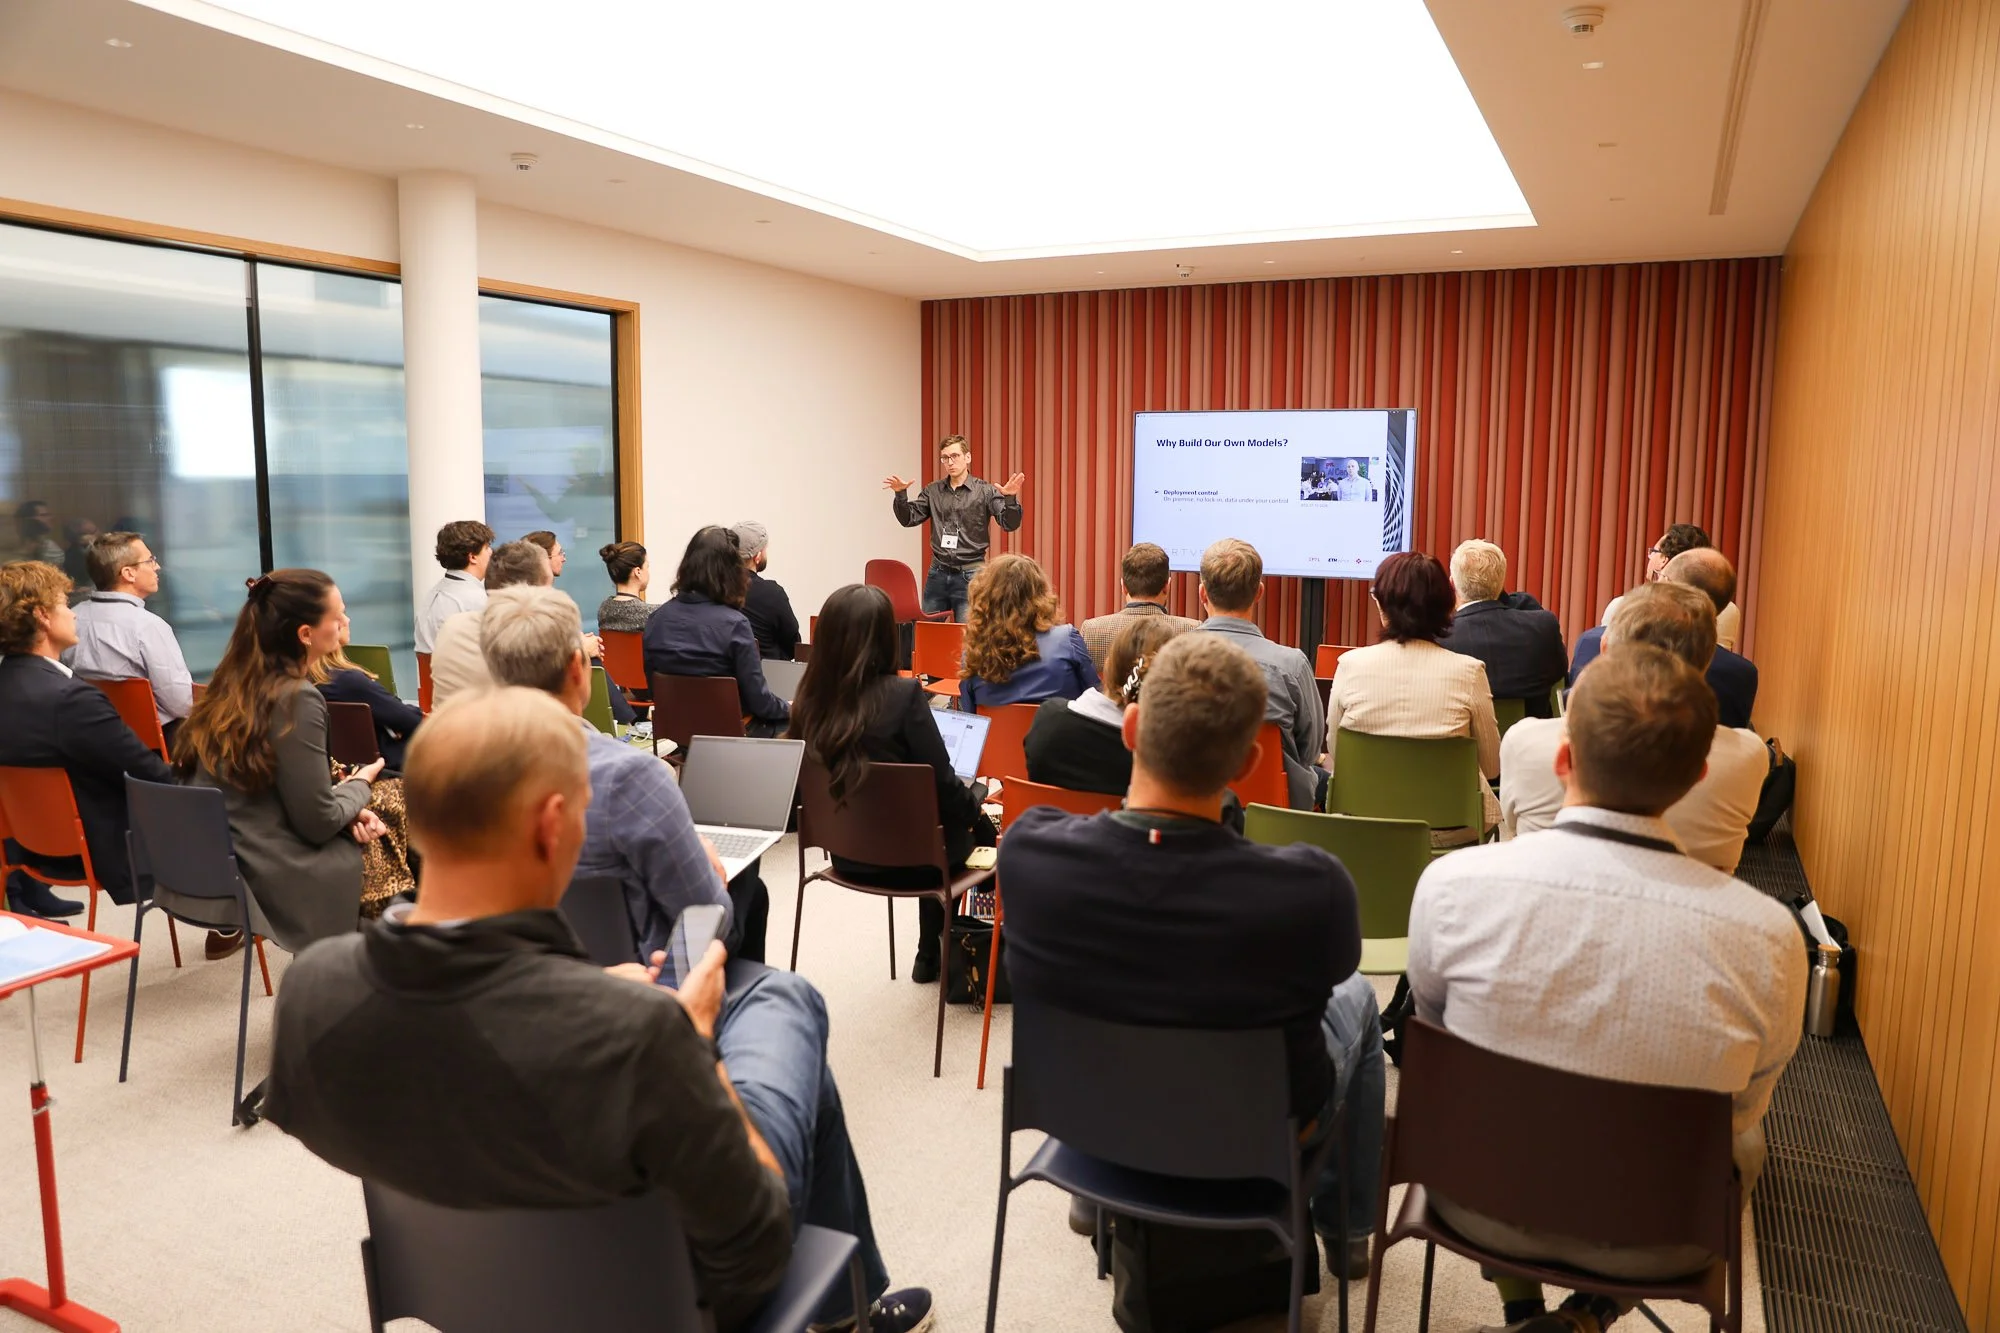
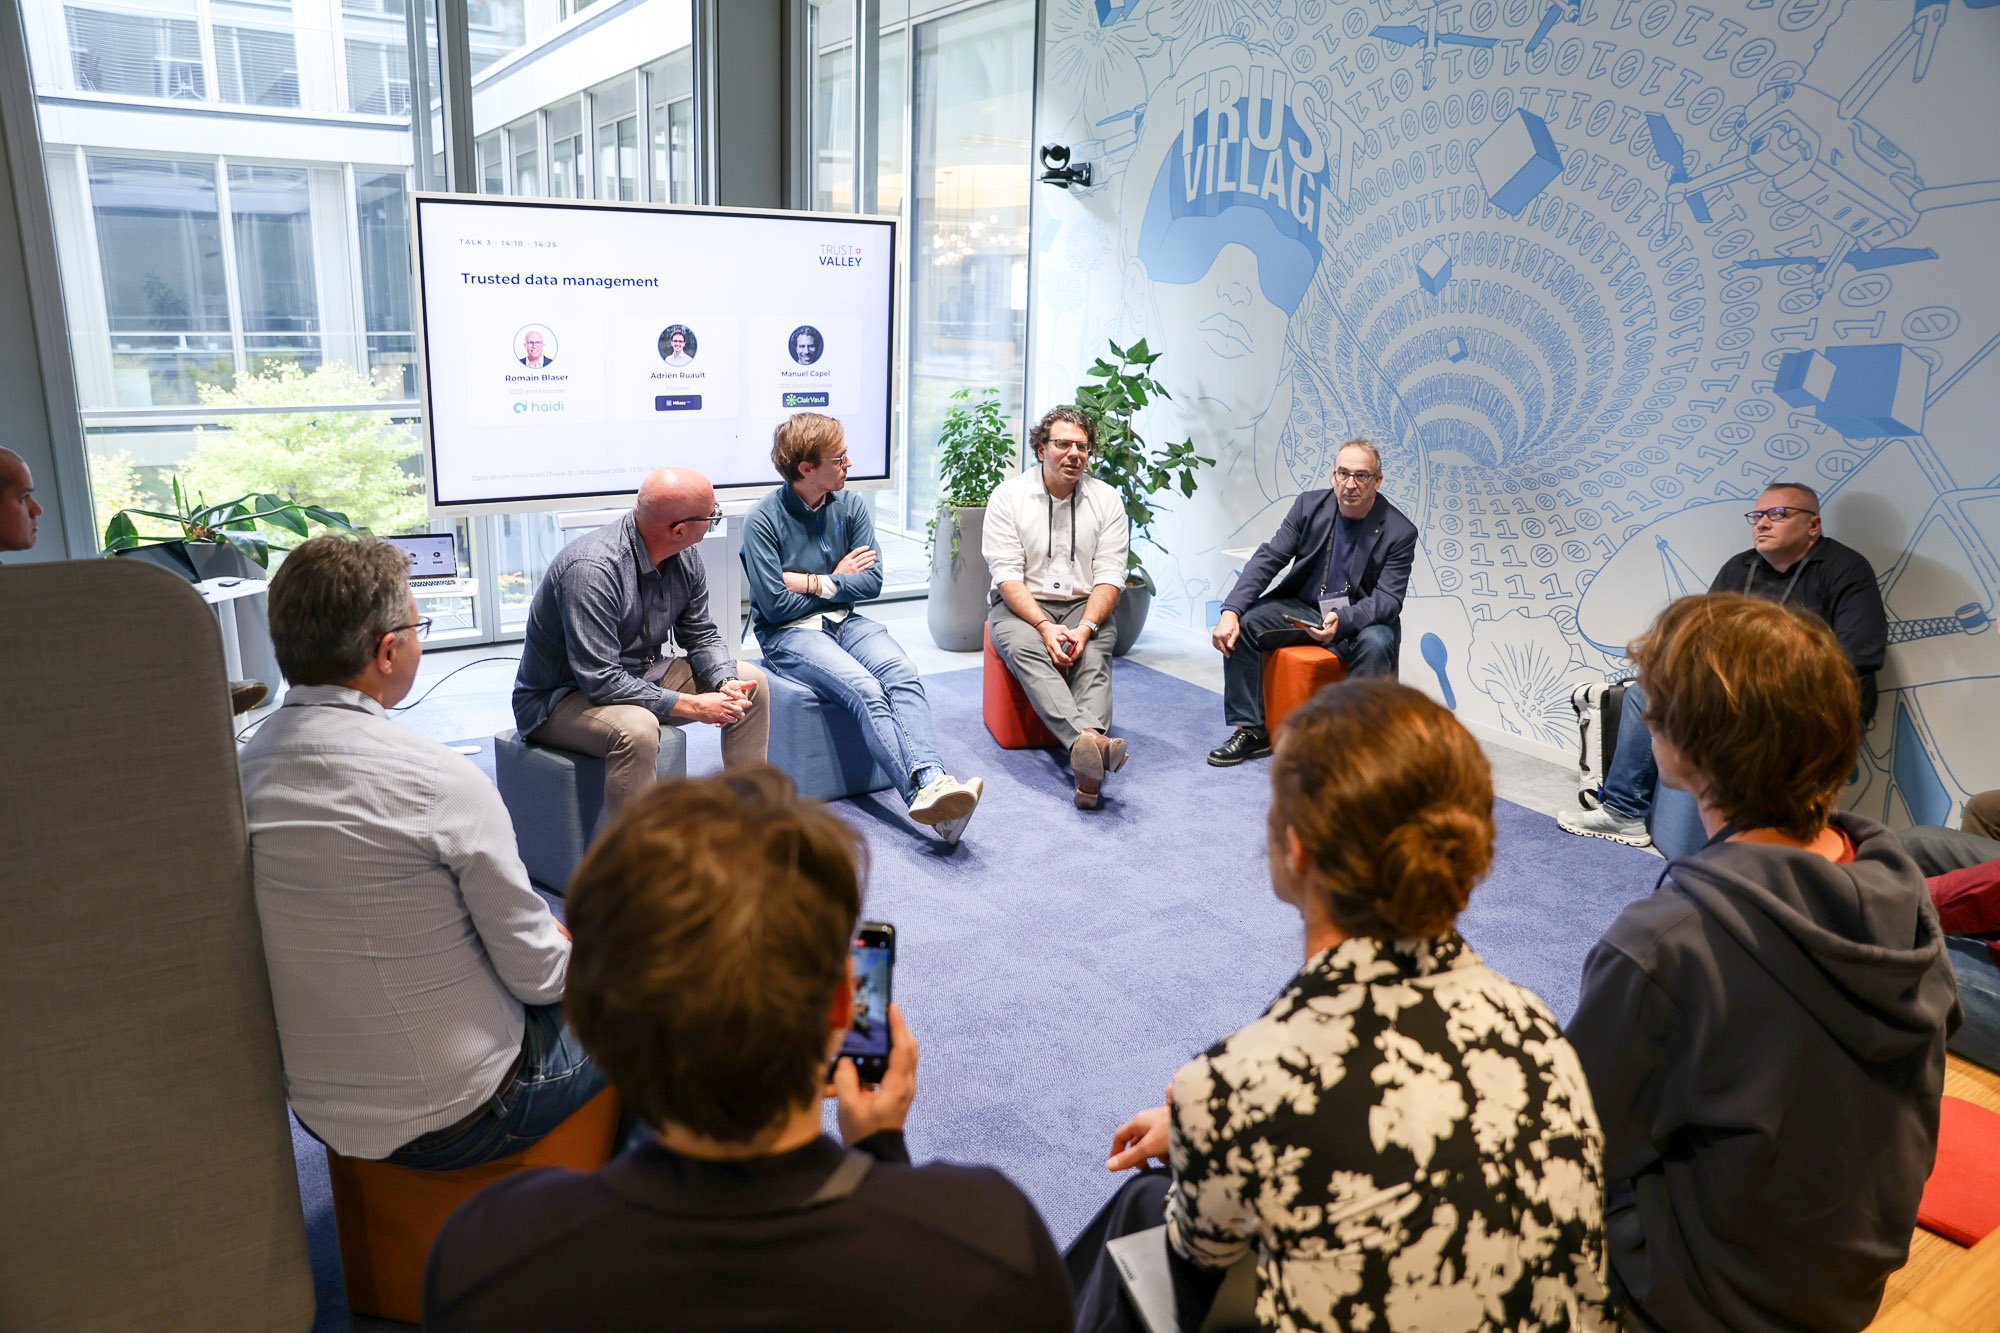
Rund 200 Personen nahmen am diesjährigen Swiss Data Space Forum 2026 am unlimitrust Campus bei Lausanne teil. Unter dem Titel «Unlocking Data for AI» brachte die von der Swiss Data Alliance und digitalswitzerland gemeinsam organisierte Veranstaltung Fachleute aus Verwaltung, Forschung, Wirtschaft und Zivilgesellschaft zusammen. Im Fokus stand der organisationsübergreifenden Datenaustausch und dessen Nutzen für künstliche Intelligenz. Die Daten bleiben in der eigenen Organisation, können aber von identifizieren Akteuren für einen bestimmten Zweck genutzt werden. Praxisbeispiele aus Gesundheit, Landwirtschaft und öffentlicher Verwaltung verdeutlichten, wie solche Ansätze umgesetzt werden können. Ein Grossteil der Präsentationen sind auf der Webseite des Swiss Data Space Forum verfügbar.
Geeignete Daten hängen vom Verwendungszweck ab
Eine zentrale Frage war, wie sich Daten für den Einsatz in KI-Systemen vorbereiten lassen. Das am Forum vorgestellte Whitepaper «AI-ready Data» der Swiss Data Alliance schafft eine gemeinsame begriffliche Grundlage dafür. Anhand von neun Anwendungsfällen zeigt es auf, dass die Eignung von Daten vom jeweiligen Verwendungszweck und ihrer Rolle im System abhängt. Entscheidend sind neben Datenqualität und Verständlichkeit auch Umfang und Vielfalt, rechtliche und sicherheitsbezogene Anforderungen sowie Auffindbarkeit, Zugänglichkeit, Interoperabilität und Wiederverwendbarkeit (FAIR-Prinzipien). Die Aufbereitung ist dabei keine einmalige Aufgabe: Daten müssen laufend gepflegt, dokumentiert und im Betrieb überprüft werden.
Digitale Souveränität setzt Fachwissen voraus
In seiner Keynote betonte Thomas Schulthess vom Swiss National Supercomputing Centre, dass digitale Souveränität über die Kontrolle des Speicherorts hinausgeht. Dazu gehöre auch die Fähigkeit, KI-Systeme zu verstehen, anzupassen und weiterzuentwickeln. Ein Workshop zum offenen Schweizer Sprachmodell Apertus vertiefte den Zusammenhang zwischen Offenheit, wissenschaftlicher Nachvollziehbarkeit und Kontrolle über den Einsatz.
Für die öffentliche Verwaltung verwies Catherine Pugin vom Kanton Waadt auf gemeinsame Standards und klare Zuständigkeiten zwischen Bund, Kantonen und Gemeinden. Nationalrätin Katja Christ stellte in ihrer Grussbotschaft einen Zusammenhang zwischen den Chancen der KI, dem Vertrauen der Bevölkerung und der Verfügbarkeit geeigneter Daten her.
Vertrauen und wirtschaftlicher Nutzen
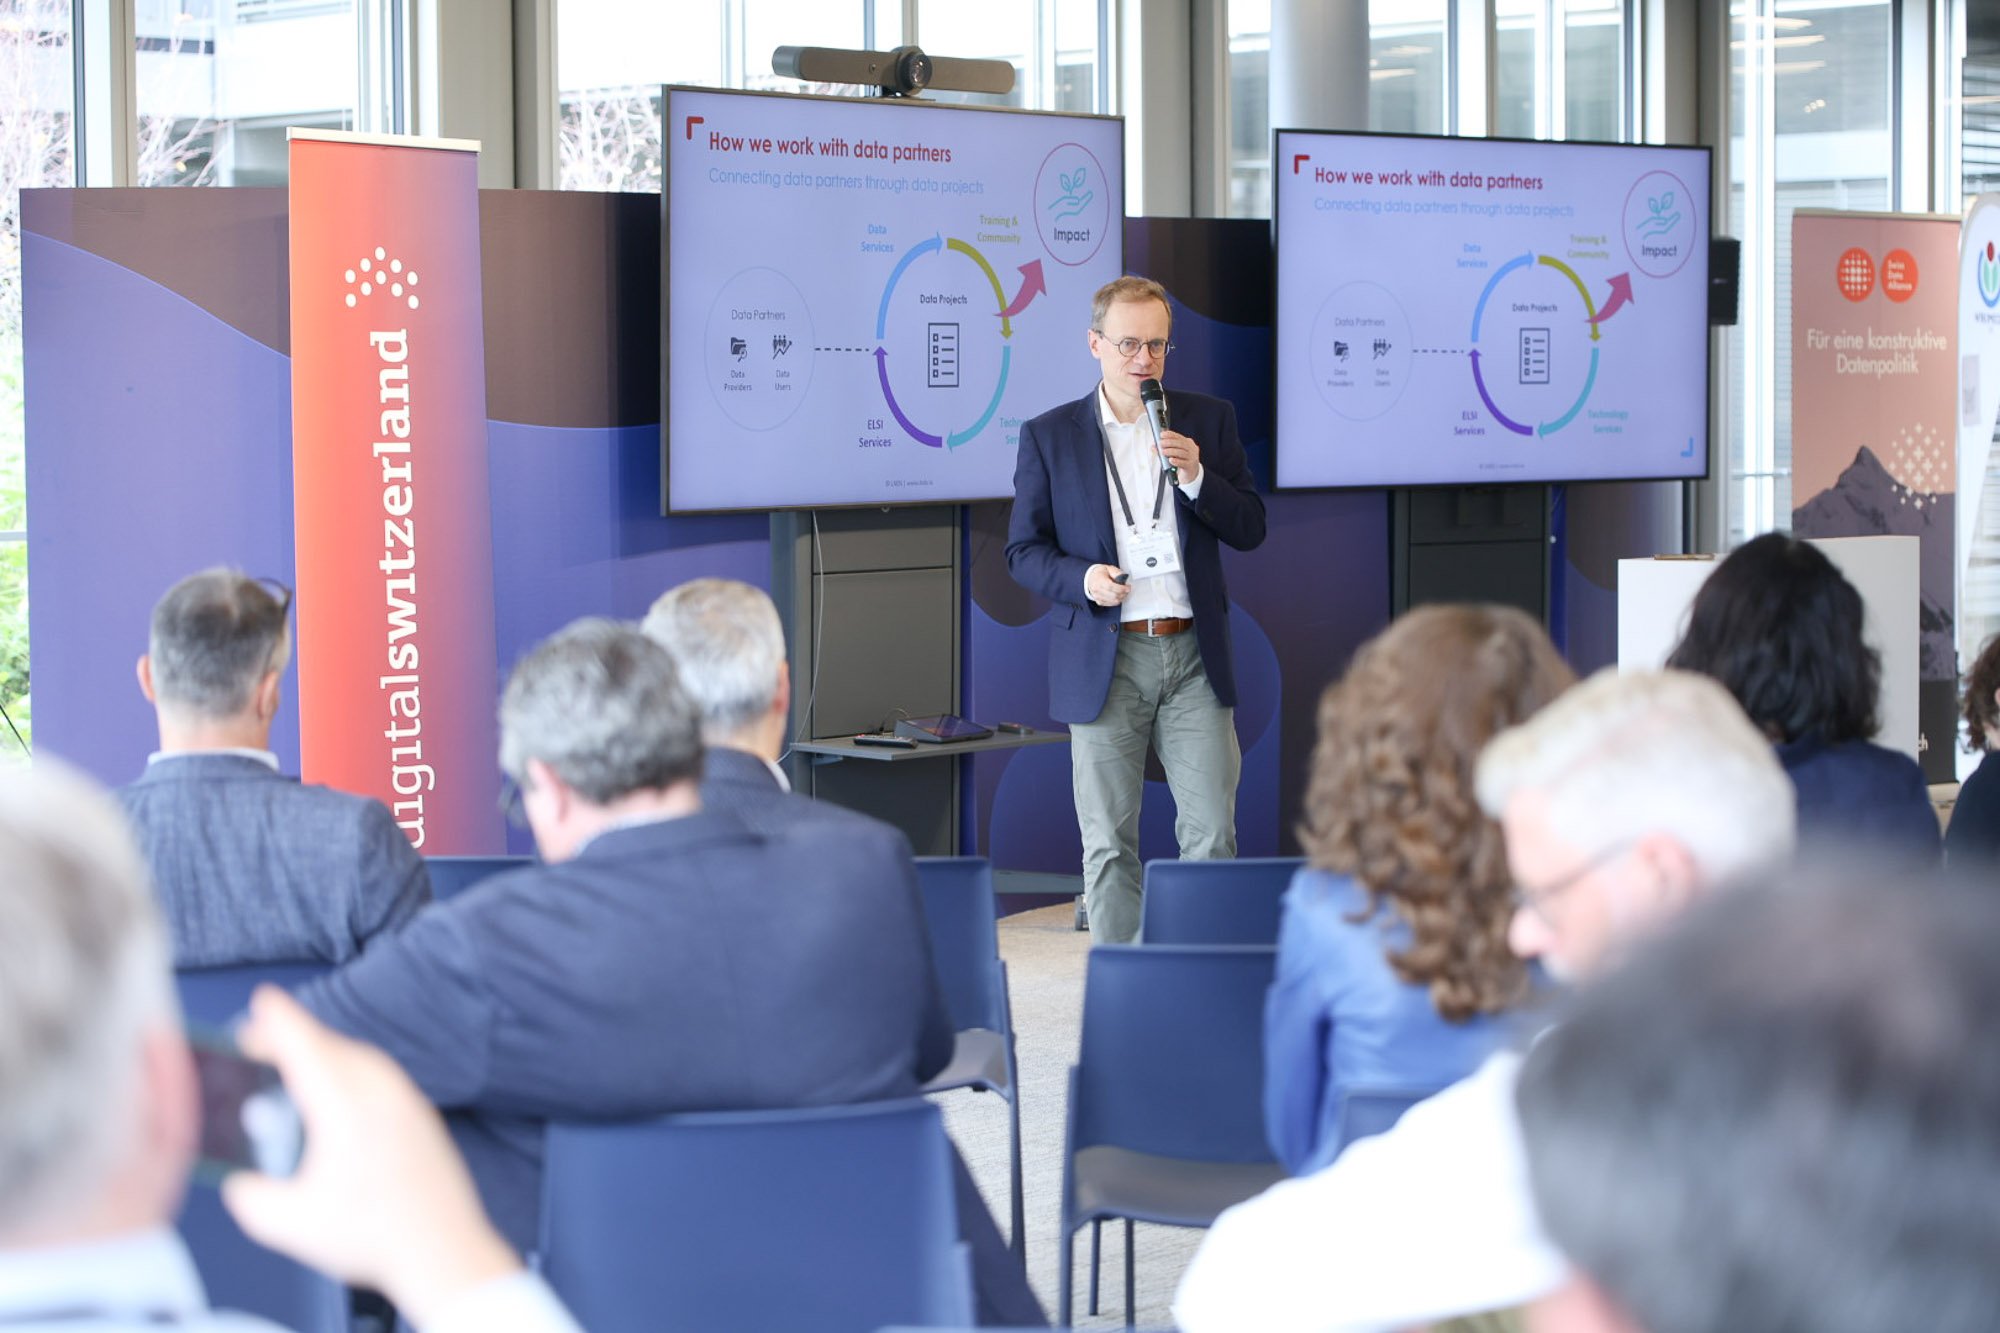
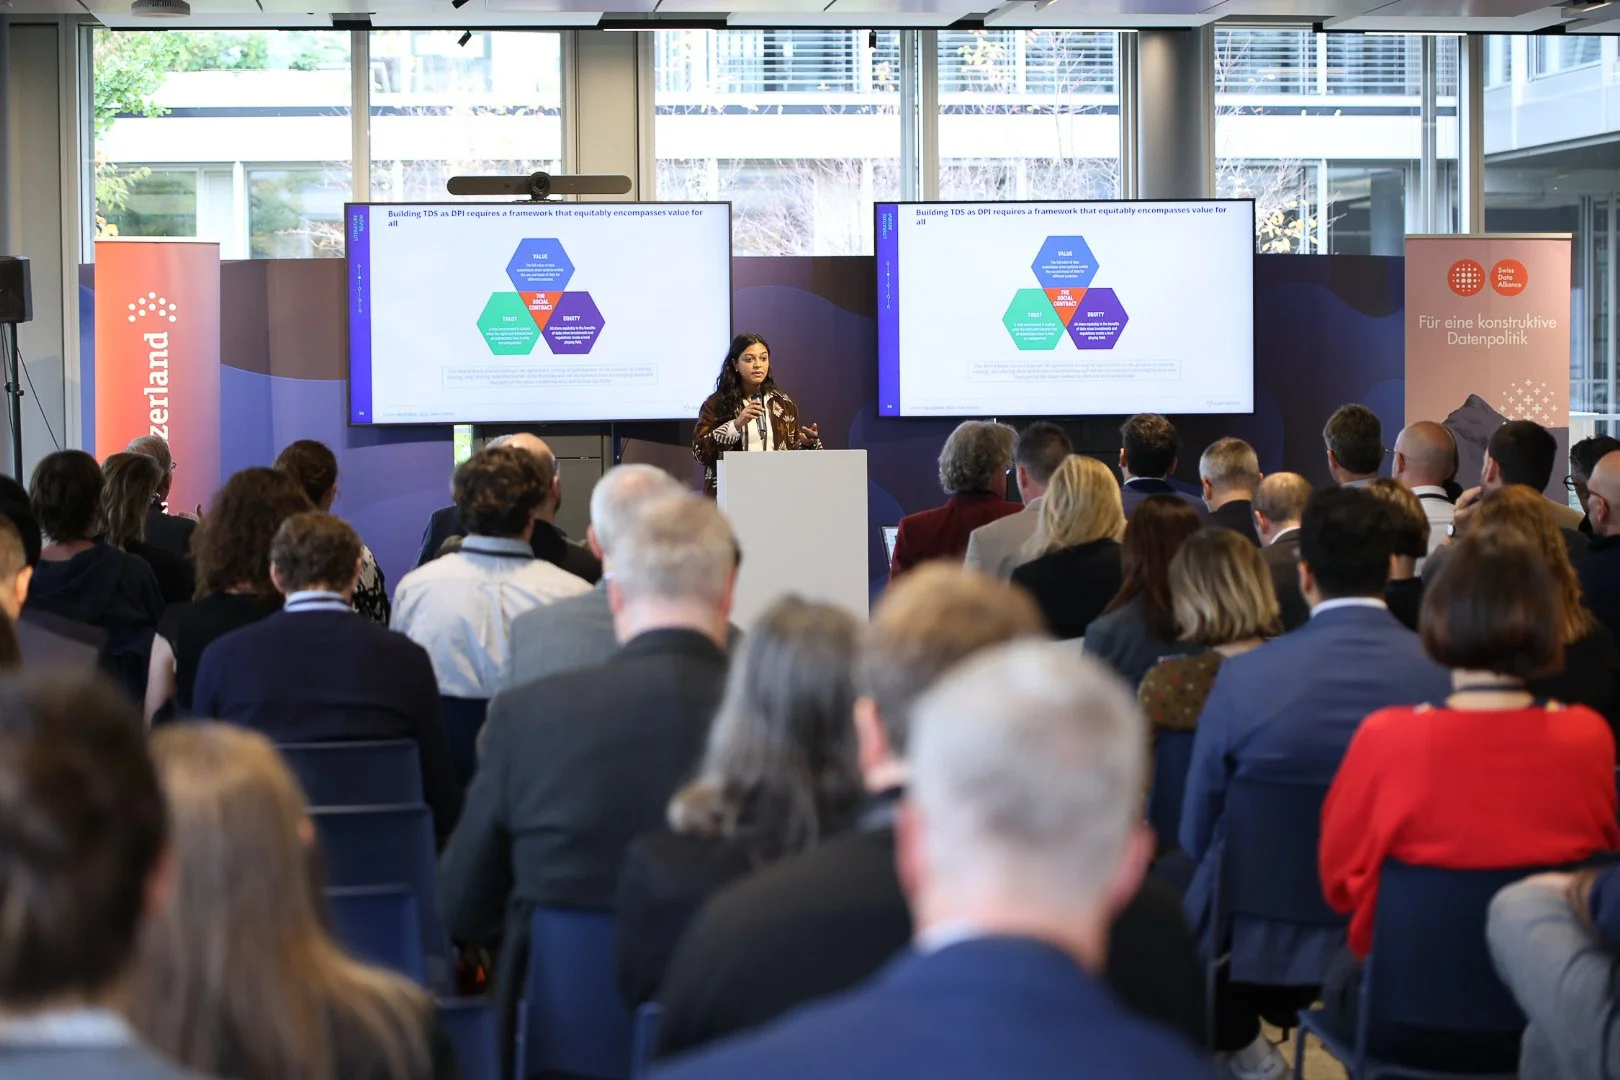
Mehrere Beiträge machten deutlich, dass technische Infrastruktur allein keinen dauerhaften Datenaustausch gewährleistet. Astha Kapoor vom indischen Aapti Institute thematisierte fehlende Fähigkeiten, unzureichende Anreize und mangelndes Vertrauen als Hindernisse. Bert Verdonck vom staatlich getragenen Luxembourg National Data Service (LNDS) erläuterte, wie die Verwaltung die Weiterverwendung bestehender Daten fördern kann, indem sie Datenanbieter und Datennutzer entlang des gesamten Datenlebenszyklus unterstützt – von der Aufbereitung und dem Zugang bis zur Analyse und zu KI-Anwendungen. Datenschutz und überprüfbare Schutzmechanismen waren weitere Schwerpunkte, unter anderem im Beitrag des Eidgenössischen Datenschutz- und Öffentlichkeitsbeauftragten Adrian Lobsiger.
Auch die Verteilung von Kosten und Nutzen spielte eine Rolle. Wenn kleinere Unternehmen Integrationskosten tragen, während der Nutzen überwiegend bei anderen Beteiligten anfällt, kann dies ihre Mitwirkung erschweren. In der Schlussdiskussion wurde deshalb auch eine Finanzierung angesprochen, die den Betrieb von Dateninfrastrukturen über einzelne Pilotprojekte hinaus sicherstellt.
Daten als digitale Gemeingüter
Alek Tarkowski und Ilario Valdelli aus der Wikimedia-Bewegung rückten zudem die Grundlagen offenen Wissens in den Blick. Wie Wikimedia in einem Whitepaper zu «Knowledge Commons» herausgearbeitet hat, nutzen KI-Dienste offen verfügbare Inhalte, beteiligen sich aber nicht an den nötigen Ressourcen für deren Erstellung und Pflege. Sie warfen die Frage auf, wie produzierende Gemeinschaften wie Wikipedia angemessen vom Nutzen ihrer Arbeit profitieren können.
Praxisbeispiele zeigen Wege zur Umsetzung
SOPHiA GENETICS stellte einen Ansatz zum Lernen über Institutionsgrenzen hinweg vor, bei dem die beteiligten Einrichtungen die Kontrolle behalten und die Datennutzung überprüfbar bleibt. Das Landwirtschaftsbeispiel agridata.ch zeigte einen funktionalen Datenraum mit Nutzungsregeln, Vereinbarungen, Einwilligungen und sicherer Übertragung.
Ein Beitrag des Kantons Bern veranschaulichte einen weiteren Entwicklungsschritt: Auch KI-Agenten können als Nutzer von Datenräumen auftreten. Damit entstehen zusätzliche Anforderungen an Zugriffsrechte, Zuverlässigkeit und Verantwortlichkeit.
Als wiederkehrende Empfehlung zog sich durch das Forum, mit einem konkreten Bedarf und überschaubaren Anwendungen zu beginnen, die Nutzenden früh einzubeziehen und den Umfang schrittweise zu erweitern. Das Forum machte damit deutlich, dass die Umsetzung ebenso von organisatorischen und wirtschaftlichen Bedingungen abhängt wie von der verfügbaren Technologie.